методология
Этот проект можно разбить на три части: сбор данных, обработка данных и анализ данных.
сбор данных
Я начал с использования сервиса Open.Trends компании SEM Rush, чтобы найти лучшие веб-сайты для каждой страны во всех отраслях. Хотя это можно сделать вручную, я автоматизировал процесс, используя библиотеки Python BeautifulSoup и Selenium-Python (в этом случае вы также можете использовать библиотеку Requests, но у меня уже был импортирован Selenium, лол). Вот некоторый псевдокод, чтобы дать вам представление о том, как это было сделано:
# run a function to get the list of countries Open.Trends has listed on their site
countries = getCountries()

# initialize a dictionary to store the information
d = {
    'country':[],
    'website':[],
    'visits':[]
}

# iterate through that list
for country in countries:
  # follow semrush's URL formatting and plug in the country using a formatted string
  url = f'https://www.semrush.com/trending-websites/{country}/all'

  # navigate to the URL using Selenium Webdriver
  driver.get(url)

  # feed the page information into BeautifulSoup
  soup = BeautifulSoup(driver.page_source, 'html.parser')

  # extract the table data using BeautifulSoup
  results = getTableData(soup)

  # feed the results into the dictionary
  d['country'] = results['country']
  d['website'] = results['website']
  d['visits'] = results['visits']

# save this into some sort of file
df = pandas.DataFrame(d)
df.save_csv('popular_websites.csv', index=False)
ПРИМЕЧАНИЕ: качество этих данных зависит от точности методов SEM Rush. Я не особо вникал в это, потому что их списки были сопоставимы с аналогичными услугами.
Теперь у вас должен быть словарь самых популярных веб-сайтов в каждой стране. Многие из этих веб-сайтов будут содержать порнографию или вредоносное ПО, или и то, и другое. Давайте попробуем отфильтровать некоторые из них с помощью API поиска URL-адресов Cyren. Это сервис, который использует «машинное обучение, эвристику и человеческий анализ» для категоризации веб-сайтов.
Вот еще псевдокод:
# iterate through all the websites we found
for i in range(len(df['website'])):
  # select the website
  url = df.loc[i,'website']
  # call the API on the website
  category = getCategory(url)
  # save the results
  df.loc[i,'category'] = category

# filter out all the undesireable categories
undesireable = [...]
df = df.loc[df['category'] in undesireable]

# save this dataframe to avoid needing to do this all over again
df.save_csv('popular_websites_filtered.csv', index=False)
ПРИМЕЧАНИЕ: Cyren URL Lookup API предоставляет 1000 бесплатных запросов в месяц на каждого пользователя.
СОВЕРШЕННО ОТДЕЛЬНОЕ ПРИМЕЧАНИЕ: Вы можете использовать такие сервисы, как временная почта для создания временных адресов электронной почты.
Теперь пришло время сделать несколько скриншотов веб-сайтов! Если вы хотите делать полностраничные снимки экрана, вам потребуется использовать веб-драйвер Firefox Selenium-Python. Если нет, подойдет любой веб-драйвер. Однако вы, вероятно, не захотите использовать полные снимки экрана, поскольку размеры веб-страниц сильно различаются, и это может сделать ваши конечные результаты менее интерпретируемыми.
def acceptCookies(...):
  # this function will probably consistent of a bunch of try-exception blocks
  # in search of a button that says accept/agree/allow cookies in every language
  # ngl i gave up like 1/3 of the way through

def notBot(...):
  # some websites will present a captcha before giving you access
  # there are ways to beat that captcha
  # i didn't even try but you should

# iterate through websites
for i in range(len(df['website'])):
  url = df.loc[i,'website]
  driver.get(url)

  # wait for the page to load
  # you shouldn't really use static sleep calls but i did
  sleep(5)
  notBot(driver)
  sleep(2)
  acceptCoookies(driver)
  sleep(2)

  # take screenshots
  driver.save_screenshot(f'homepage_{country.upper()}_{url}.png')

  # this call only exists for firefox webdrivers
  driver.save_full_page_screenshot(f'homepage_{country.upper()}_{url}.png')
ПРИМЕЧАНИЕ: При этом вы можете использовать VPN для перехода в соответствующую страну/регион, чтобы повысить вероятность просмотра местной веб-страницы.
обработка данных
я в основном следил этот урок Григорий Серебряков на LearnOpenCV. Он использует реализацию модели ResNet для извлечения характеристик изображения. Вы можете взять код из его сообщения в блоге, но нам нужно загружать изображения по-другому. Мы можем использовать этот метод Эндрюджонга (источник). Нам нужно сохранить пути к файлам изображений для использования в нашей окончательной визуализации.
class ImageFolderWithPaths(datasets.ImageFolder):
    """Custom dataset that includes image file paths. Extends
    torchvision.datasets.ImageFolder
    """

    # override the __getitem__ method. this is the method that dataloader calls
    def __getitem__(self, index):
        # this is what ImageFolder normally returns
        original_tuple = super(ImageFolderWithPaths, self).__getitem__(index)
        # the image file path
        path = self.imgs[index][0]
        # make a new tuple that includes original and the path
        tuple_with_path = (original_tuple + (path,))
        return tuple_with_path
теперь мы можем загружать наши изображения, используя этот метод.
# identify the path containing all your images
# if you want them to be labeled by country, you will need to sort them into folders

root_path="..."

# transform the data so they are identical shapes
transform = transforms.Compose([transforms.Resize((255, 255)),
                                 transforms.ToTensor()])
dataset = ImageFolderWithPaths(root, transform=transform)

# load the data
dataloader = torch.utils.data.DataLoader(dataset, batch_size=32, shuffle=True)
затем мы инициализируем и запускаем нашу модель. Мне нужно было немного адаптировать код Серебрякова, чтобы учесть, как загружаются наши изображения.
# initialize model
model = ResNet101(pretrained=True)
model.eval()
model.to(device)

# initialize variables to store results
features = None
labels = []
image_paths = []

# run the model
for batch in tqdm(dataloader, desc="Running the model inference"):

  images = batch[0].to('cpu')
  labels += batch[1]
  image_paths += batch[2]

  output = model.forward(images)
  # convert from tensor to numpy array
  current_features = output.detach().numpy()

  if features is not None:
      features = np.concatenate((features, current_features))
  else:
      features = current_features

# return labels too their string interpretations
labels = [dataset.classes[e] for e in labels]

# save the data
np.save('images.npy', images)
np.save('features.npy', features)
with open('labels.pkl', 'wb') as f:
  pickle.dump(labels, f)
with open('image_paths.pkl', 'wb') as f:
  pickle.dump(image_paths, f)
теперь у нас должно быть 4 набора данных, содержащих пути к нашим изображениям, метки, изображения и их извлеченные функции.
анализ данных
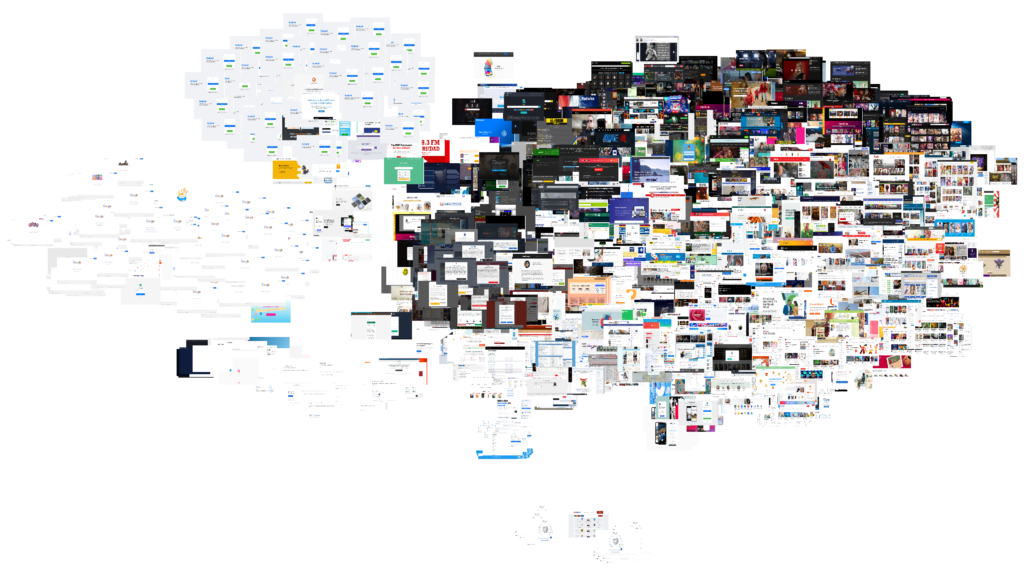
мы начнем с обработки наших данных через реализацию tsne в sci-kit. По сути, это сводит наши многомерные массивы объектов к двумерным координатам, которые мы можем нанести на график. Мы можем сопоставить уменьшенные версии наших снимков экрана с этими координатами, чтобы увидеть, как машина организовала наши веб-сайты.
# the s in t-SNE stands for stochastic (random)
# let's set a seed for reproducible results
seed = 10
random.seed(seed)
torch.manual_seed(seed)
np.random.seed(seed)

# run tsne
n_components = 2
tsne = TSNE(n_components)
tsne_result = tsne.fit_transform(features)

# scale and move the coordinates so they fit [0; 1] range
tx = scale_to_01_range(tsne_result[:,0])
ty = scale_to_01_range(tsne_result[:,1)

# plot the images
for image_path, image, x, y in zip(image_paths, images, tx, ty):
  # read the image
  image = cv2.imread(image_path)

  # resize the image
  image = cv2.resize(image, (150,100))

  # compute the dimensions of the image based on its tsne co-ordinates
  tlx, tly, brx, bry = compute_plot_coordinates(image, x, y)

  # put the image to its t-SNE coordinates using numpy sub-array indices
  tsne_plot[tl_y:br_y, tl_x:br_x, :] = image

cv2.imshow('t-SNE', tsne_plot)
cv2.waitKey()
теперь мы можем искать любые визуальные закономерности на изображениях. То, что я нашел, было подробно описано в разделах выше.
я хотел понять эти данные через призму систем письменности, культуры (географически и экономически) и технологий. Итак, я нашел наборы данных, содержащие эту информацию: системы письма, страны ISO с региональными кодамии глобальный раскол между севером и югом. Их нужно было дополнить дополнительным поиском в Google, чтобы убедиться, что у нас есть ярлыки для каждой страны в нашем наборе данных.
Вот базовое описание того, как я использовал эти новые данные анализа.
analysis_data = # import data

# initialize a list to capture a parallel set of labels
# so instead of the country, we can label our data through writing system, etc.
new_labels = []

# iterate through our pre-existing labels and use it to inform our new_labels
for label in labels:
  # select the new_label based on the old label (the country name)
  new_label = analysis_data['country' == label]
  new_labels.append(new_label)

# use the new_labels to colour a scatterplot with our tsne_results
tsne_df = pd.DataFrame({'tsne_1': tx, 'tsne_2': ty, 'label': new_labels})
sns.scatterplot(x='tsne_1', y='tsne_2', data=tsne_df, hue="label")
ПРИМЕЧАНИЕ: В технологическом аргументе использован более качественный метод, и он здесь не рассматривается.
мы можем увидеть результаты этих сравнений в разделах выше.

ответ в разработке проекта
2026-02-23 14:28:00
1771860887
#sabrinas.space
Продолжение темы

